NATIONAL INDUSTRY ALLIANCE FOR MARINE DRUGS AND BIOPRODUCTS
FOCUS ON US
微生物次级代谢产物,是抗生素、抗肿瘤药物等创新药的核心来源,但全球99%微生物不可培养,海量隐秘生物合成基因簇(BGC)长期无法转化为明确化学结构,天然产物发现陷入 “基因海量、结构未知” 的核心瓶颈。
📍本研究由复旦大学赵国屏院士领衔、联合同济大学、中科院团队,新登Nature 子刊:
○以深度学习大语言模型为核心,首次实现BGC 序列→次级代谢产物结构端到端生成;
○依托全球海洋微生物组大规模数据,建立超6万种海洋天然产物库,让海洋隐秘合成通路第一次被AI系统性解码;
○ 从“基因发现” 到 “结构解析+药物筛选”,实现天然产物挖掘的跨越式突破。
' fill='%23FFFFFF'%3E%3Crect x='249' y='126' width='1' height='1'%3E%3C/rect%3E%3C/g%3E%3C/g%3E%3C/svg%3E)
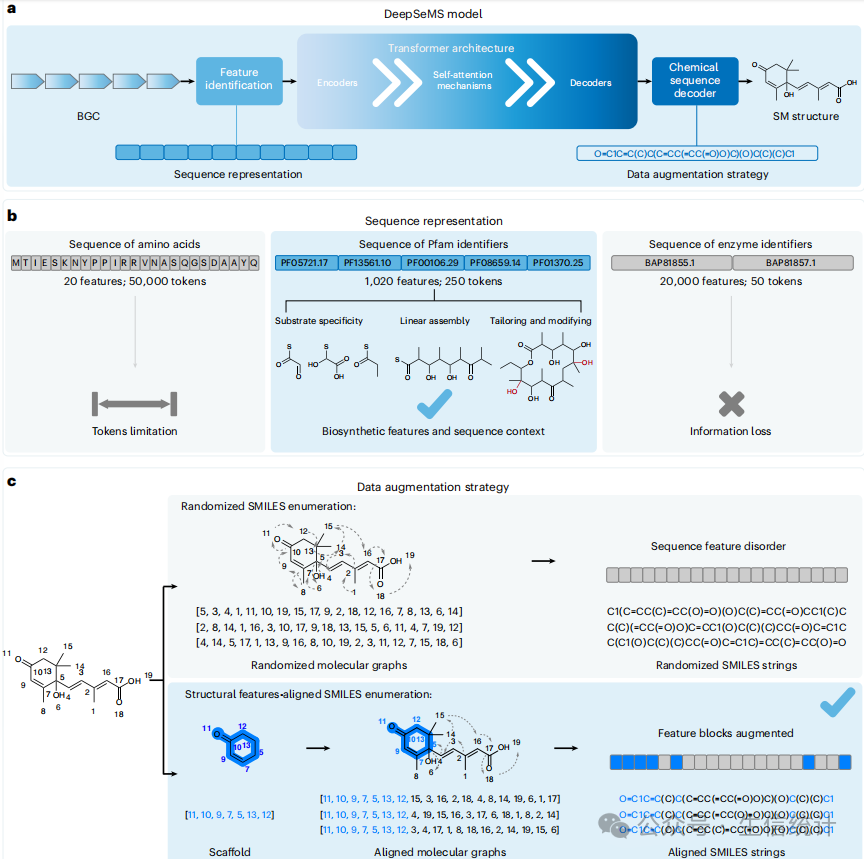
1.首次将Transformer大语言模型应用于BGC→SM结构预测,把基因序列翻译为化学结构,突破规则型工具的局限。
2.完成全球海洋微生物组超大规模深度学习预测,构建海洋天然产物数据库。
BGC(生物合成基因簇)、SM(次级代谢产物)、SMILES(化学结构编码)、Pfam(蛋白结构域注释)、Cryptic BGC(隐秘基因簇)。
化学有效性:生成 SMILES可被识别为合法分子的比例

方法
基于Transformer架构搭建LLM,输入为Pfam 功能域序列,输出为SMILES,10折交叉验证集成预测。
训练数据来MIBiG 3.1(3029对BGC-SM);使用特征对齐SMILES增强扩充数据。
Ocean Microbiomics Database(OMD) 获取27139个MAGs,鉴定45894 个BGC,用DeepSeMS预测并分析。
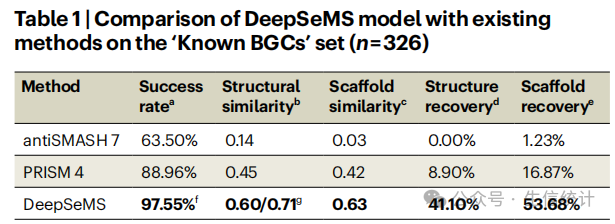
表 1.DeepSeMS模型与现有方法在“已知BGCs”数据集上的性能比较
亮点:小样本下仍保持高精度,证明生物先验编码 + 深度学习的组合可广泛迁移到其他序列 - 结构预测任务。
图 1.在隐蔽BGCs测试数据集上,DeepSeMS与现有方法的比较
复刻建议:先做结构域编码、再做骨架保持增强,是提升隐秘序列预测的关键步骤,可直接复刻到宏基因组数据挖掘。
(图 2)
图 2.全球海洋表面微生物的分子新颖性与多样性
亮点:深度学习首次实现海洋天然产物规模化发现,证明AI可高效挖掘未培养微生物的暗物质资源。
基于结构虚拟筛选,鉴定出7554个含抗生素特征骨架分子与1884个四氢嘧啶类似物,部分来自全新未分类 BGC 家族。(图 3)
图 3.全球海洋SMs的生物医学应用潜力
亮点:预测+筛选一体化,可直接作为AI驱动药物发现的标准流程,大幅降低实验验证成本。
本研究以深度学习(Transformer 大语言模型) 为核心技术,攻克了BGC到化学结构预测的行业瓶颈,在已知/隐秘BGC上均实现远超传统工具的性能,并首次用AI规模化解锁全球海洋微生物组的天然产物资源,是微生物组学与深度学习结合的突破性成果。
来源 微信公众号 · 查看原文
版权申明 本网站立足国家海洋药物和生物制品产业联盟,致力于打造海洋生物医药“产学研用”一站式、综合性资讯共享服务平台,促进我国海洋药物和功能制品“资源链、科技链、产业链、应用链”协同创新、深度融合发展。本文转载自原文来源。版权归原作者及原来出处所有,部分文章未能联系到原作者,在此深表歉意。如涉及版权问题,请留言联系我们协商处理(邮箱:czhang@tio.org.cn),侵权内容将即刻删除。
免责声明 本文仅代表作者个人观点,与本平台立场无关。本站不对内容真实性、完整性、时效性作保证,仅供参考,请读者自行核实。